Как собрать точный коллаж в FLUX 3 Image за 10 минут
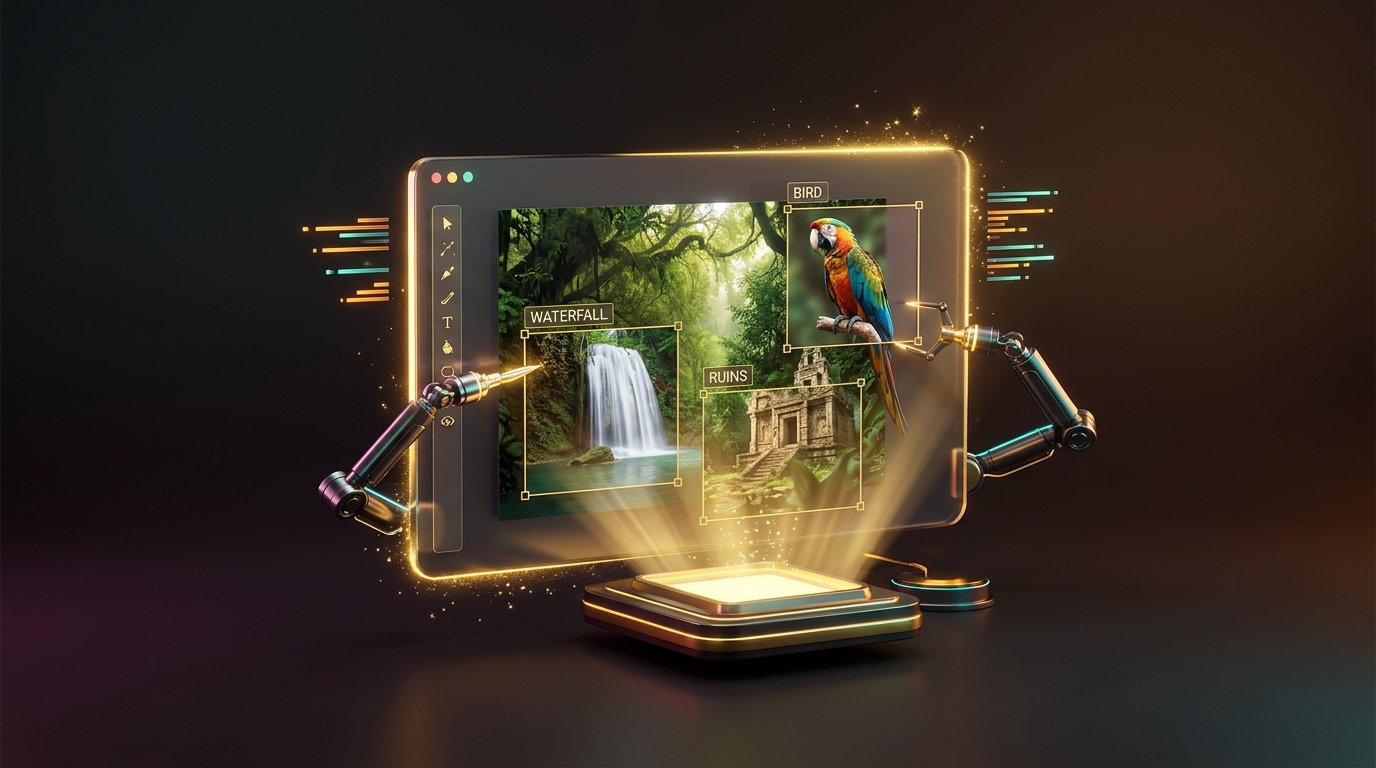
Есть особый жанр разочарования: просишь нейросеть поправить только фон, а она заодно перерисовывает лицо героя, меняет цвет его рубашки и почему-то добавляет второго кота. Black Forest Labs, судя по всему, устала от этих писем в поддержку и выпустила FLUX 3 Image — картиночную часть своего мультимодального семейства FLUX 3. Главный трюк модели простой и по-хорошему скучный: она обещает трогать только то, что вы попросили тронуть, и ничего больше.
Что вообще нового в FLUX 3 Image
Если коротко: модель умеет текст-в-картинку и редактирование по референсам, причём референсов можно подкинуть сразу несколько — до десяти штук. Это уже не «нарисуй мне кота», а «возьми стиль с картинки 1, позу с картинки 2 и фон с картинки 3». Разрешение тоже подросло: модель рендерит нативно вплоть до 4K, так что мелкие детали вроде текстуры ткани или надписей на вывесках не превращаются в кашу.
Но главная фишка — управление через рамки (bounding boxes). Вместо того чтобы описывать композицию прозой и надеяться, что модель вас правильно поймёт, вы буквально расставляете прямоугольники на сетке и подписываете, что должно быть внутри каждого. Хотите купол слева, вывеску справа и человека по центру — просто задаёте координаты. Композиция перестаёт быть лотереей.
Почему это решает старую боль с редактированием
Раньше любое редактирование фото через нейросеть было немного похоже на ремонт в квартире соседей: просишь поклеить обои в одной комнате, а в итоге перекрашена вся квартира. FLUX 3 Image обещает многошаговое редактирование, при котором нетронутые пиксели остаются буквально неизменными на уровне данных — не «визуально похоже», а численно те же самые. Для практики это значит, что можно вносить правки по одной, не боясь, что десятая итерация будет выглядеть совсем не как первая.
Это особенно приятно для тех, кто готовит карточки товаров, баннеры или коллажи: правишь только текст на этикетке — и фон, свет, тени остаются на месте. Не нужно каждый раз генерировать всё заново и выцеплять удачный вариант из десяти похожих, но не идентичных.
Как это выглядит на практике за 10 минут
Распишем реалистичный сценарий для новичка, у которого нет времени разбираться в документации:
- Минута 1-2. Собираете референсы: фото товара, желаемый фон или стиль, логотип бренда, если нужен.
- Минута 3-5. Загружаете их как референсные изображения и в промпте простыми словами описываете, что откуда взять: «фон из картинки 1, товар из картинки 2, добавить тень как в естественном освещении».
- Минута 6-7. Если нужна точная композиция — например, товар строго по центру, текст в верхнем углу, — расставляете рамки руками в плеиграунде или задаёте координаты текстом.
- Минута 8-9. Получаете результат и правите точечно: не всю картинку, а конкретный элемент внутри одной рамки.
- Минута 10. Экспортируете в нужном разрешении — для соцсетей хватит среднего, для баннера на сайт берёте вариант ближе к 4K.
Никакой магии, просто меньше случайностей на каждом шаге — а это именно то, что экономит время, а не ощущение скорости без реального результата.
Что стоит иметь в виду
Модель пока доступна через API и плейграунд, открытых весов для локального запуска нет — обещают, но без конкретной даты. Если вам важно гонять генерацию на своём железе без облака, придётся либо подождать, либо пока остаться на предыдущих версиях FLUX. Ещё момент: независимые бенчмарки пока не публиковали подробных цифр качества FLUX 3 Image в сравнении с конкурентами, так что все заявления о «лучшем в своём классе» стоит воспринимать как маркетинг, а не как итог независимого теста. Модель явно сильна в контроле композиции и точечном редактировании — но будет ли она однозначно лучше по фотореализму или художественной выразительности, покажет только практика и время.
Коротко
FLUX 3 Image не переизобретает генерацию картинок, но решает конкретную и всем знакомую проблему — непредсказуемость редактирования. Рамки для композиции и пиксель-точные правки — это как раз те мелочи, которые превращают нейросеть из генератора случайностей в рабочий инструмент. Попробовать FLUX и другие актуальные модели для генерации изображений можно в GEMERA AI — без танцев с API-ключами и настройкой окружения, прямо в боте или веб-кабинете.