Получится ли сохранить одно лицо в десяти разных ИИ-портретах подряд?
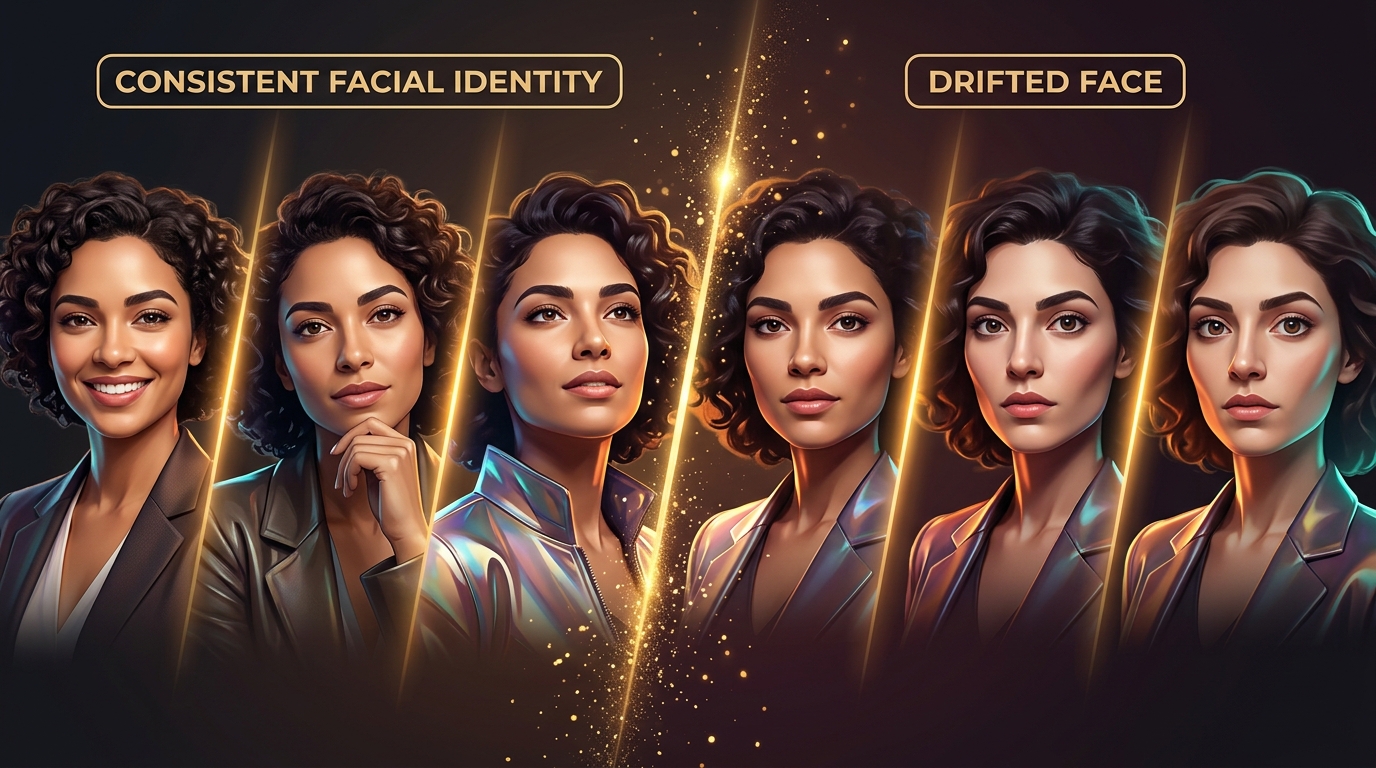
На прошлой неделе пересохранял одну и ту же девушку в нейросети раз пятнадцать: то свет не тот, то причёска вдруг отросла, то лицо стало чужим. Знакомая боль для всех, кто делает серию портретов, аватарки для бренда или карточки персонажа. Разбираю один конкретный приём, который реально решает эту проблему — и объясняю, почему он сработал именно сейчас, когда вышли новые версии генераторов изображений.
В чём суть приёма и почему он работает?
Приём простой по формулировке и сложный по дисциплине: сначала зафиксируй, что остаётся неизменным, и только потом описывай одно изменение за раз. Не переписывай промпт целиком под каждый новый кадр — редактируй поверх уже принятого результата.
Это не моя придумка, а прямая рекомендация из свежего гайда по работе с GPT Image 2.5: модель вознаграждает бриф, который можно разобрать, а не более длинный список прилагательных. И дальше там же прямое правило: меняйте по одному сбою за раз. Полная переписка уничтожает сравнение между ходами. Звучит как банальность, но именно это большинство новичков делает неправильно — переписывает запрос от нуля, когда нужно было просто поправить одну деталь.
С чего начинать — с референса или с текста?
С референса, если лицо реальное или уже утверждено клиентом. Сначала лок, потом одно изменение — в буквальном смысле это строка в начале промпта вида «сохрани то же лицо и силуэт волос», а дальше одна правка: фон, одежда или ракурс.
Если лица без референса нет — создаёшь первый кадр, принимаешь его как эталон и дальше работаешь только с ним, а не генерируешь заново «с нуля» под каждую вариацию. Для портретной съёмки без исходного фото это особенно важно: иначе каждая генерация — лотерея с новым случайным лицом.
Какую формулировку промпта реально использовать?
Рабочая структура выглядит так:
- Фиксация — что должно остаться без изменений (лицо, причёска, пропорции);
- Одно действие — ракурс, одежда, фон или свет, но не всё сразу;
- Материал и свет — конкретика вместо похвалы. В одном из свежих гайдов по промптам приводят пример разницы между слабой и сильной формулировкой: вместо просто «realistic skin» пишут natural skin, visible pores, no beauty blur, no plastic skin, и это ощутимо меняет результат;
- Запреты — что точно не должно появиться (лишний текст, вотермарки, пластиковая кожа).
Моё личное наблюдение: чем конкретнее формулировка материала и света, тем меньше модель «доигрывает» за тебя лицо — и тем выше шанс, что оно останется прежним.
В каких нейросетях это реально работает?
Повод для этой колонки — свежий релиз: 8 сентября 2026 года OpenAI выпустила обновление ChatGPT Images 2.5, которое представило функцию Sketch для превращения рисунков в изображения, а задержка генерации снизилась до 50%, с двумя версиями API — Flare для скорости и Sunburst для детализации за счёт времени.
Для серии портретов с упором на сходство логичнее стартовать с Sunburst — там выше детализация, а на вариациях уже переходить на Flare для скорости. Похожая логика применима и к Nano Banana Pro от Google: у неё отдельно отмечают умение создавать кристально чистые изображения с детализацией готовой к 2K–4K, где текстуры, материалы, отражения, тени и мелкие черты рендерятся с профессиональной точностью — то есть база для портрета получается плотная, и держать лицо на правках проще.
Отдельный пример того же подхода «лок плюс изменение» — свежая модель редактирования в Midjourney V8.2, которая умеет принимать инструкции текстом, собирать изображение из других изображений — до четырёх образцов — а также закрашивать кистью область для замены и дорисовывать за пределами кадра. Инструмент другой, но идея та же: не пересоздавать картинку целиком, а точечно редактировать то, что нужно изменить.
Что чаще всего ломает сходство?
Три типичные ошибки, которые видел у новичков и у себя:
- Переписывание всего промпта ради одной мелкой правки — модель теряет контекст предыдущего кадра;
- Слишком общие формулировки вроде «та же девушка» без конкретики по чертам лица и силуэту;
- Смешение нескольких изменений в одном шаге — поменять одновременно ракурс, одежду и фон почти гарантированно уводит лицо в сторону.
Если кадр не получился — не генерируй заново с нуля. Откатись к последнему принятому варианту и попробуй другую формулировку того же единственного изменения.
Стоит ли так делать для коммерческих задач?
Да, и это, пожалуй, главный практический вывод колонки. Для брендовых аватаров, серии карточек персонажа или рекламной кампании с одним лицом этот приём экономит часы ручной ретуши. Но дисциплина важна: как только начинаешь экономить время и менять всё сразу — экономия исчезает, потому что на проверку расхождений уходит больше, чем на аккуратную поэтапную правку.
Вместо вывода
Один приём — зафиксировать неизменное, менять по одному шагу — работает не потому, что модели стали умнее угадывать намерения, а потому что человек сам перестаёт путать их случайностью собственного промпта. Это не волшебная кнопка, а рабочая дисциплина, которая окупается уже на третьем кадре серии.
Если хочешь попробовать этот приём на практике — GPT Image 2.5, Nano Banana Pro и другие модели для генерации изображений уже доступны в GEMERA AI через Telegram-бота и веб-кабинет. Можно сразу сравнить, какая модель лучше держит лицо именно на твоих задачах.